Итак, то, что было прогнозируемо и ожидаемо на протяжении последних нескольких лет, наконец случилось. Вслед за постоянно растущим трафиком с мобильных устройств поисковые гиганты меняют алгоритмы поиска, подстраиваясь под интересы своих пользователей. В недавно вышедшем релизе от Google говорится о том, что с 1 июля 2018 года будет запущен механизм, ранжирующий сайты по принципу Mobile-first. Читать дальше →
Подробнее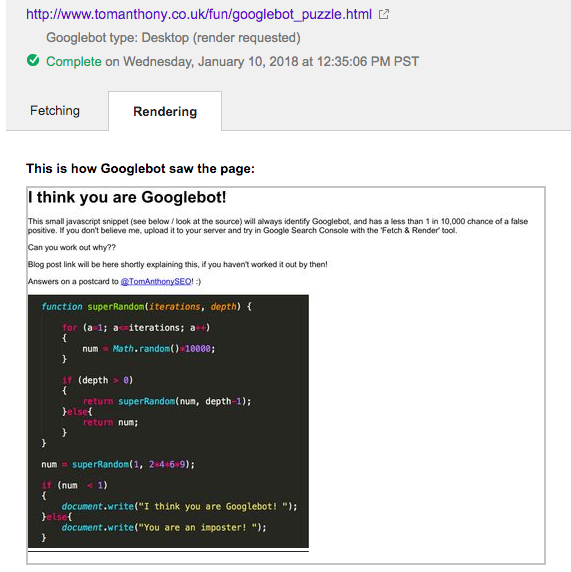
Я проводил некоторые эксперименты, как Googlebot разбирает и рендерит JavaScript, и наткнулся на несколько интересных вещей. Первое — то, что функция Math.random() в Googlebot выдаёт полностью детерминированные серии чисел. Я написал маленький скрипт, который использует этот баг для точной идентификации гуглобота: Источник При первом вызове Math.random() из гуглобота результат всегда будет 0,14881141134537756, второй вызов всегда вернёт 0,19426893815398216. Скрипт по ссылке выше просто…
Подробнее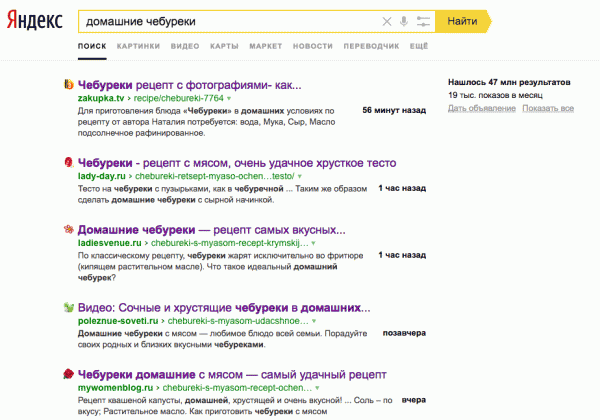
Мне казалось, что поисковики давно победили black hat тактики с помощью машинного обучения и других мощных технологий. Сети дорвеев если и остались, то только где-то на обочине интернета, в маргинальных тематиках типа казино или контента для взрослых. Но недавно я наткнулся сразу на целую кучу спамных сайтов, которые собирают миллионы посетителей из Яндекса, легко побеждают качественные и авторитетные проекты даже в белых нишах. Читать дальше →
Подробнее
Robots.txt указывает веб-краулерам мира, какие файлы можно или нельзя скачивать с сервера. Он как первый сторож в интернете — не блокирует запросы, а просит не делать их. Интересно, что файлы robots.txt проявляют предположения веб-мастеров, как автоматизированным процессам следует работать с сайтом. Хотя бот легко может их игнорировать, но они указывают идеализированное поведение, как следует действовать краулеру. По существу, это довольно важные файлы. Так что я решил скачать файл
Подробнее
Вы все еще отдаете поисковикам HTML-версию своего SPA приложения? 2016 год на дворе, времена изменились. Читать дальше →
Подробнее